
在 Mac 上实测
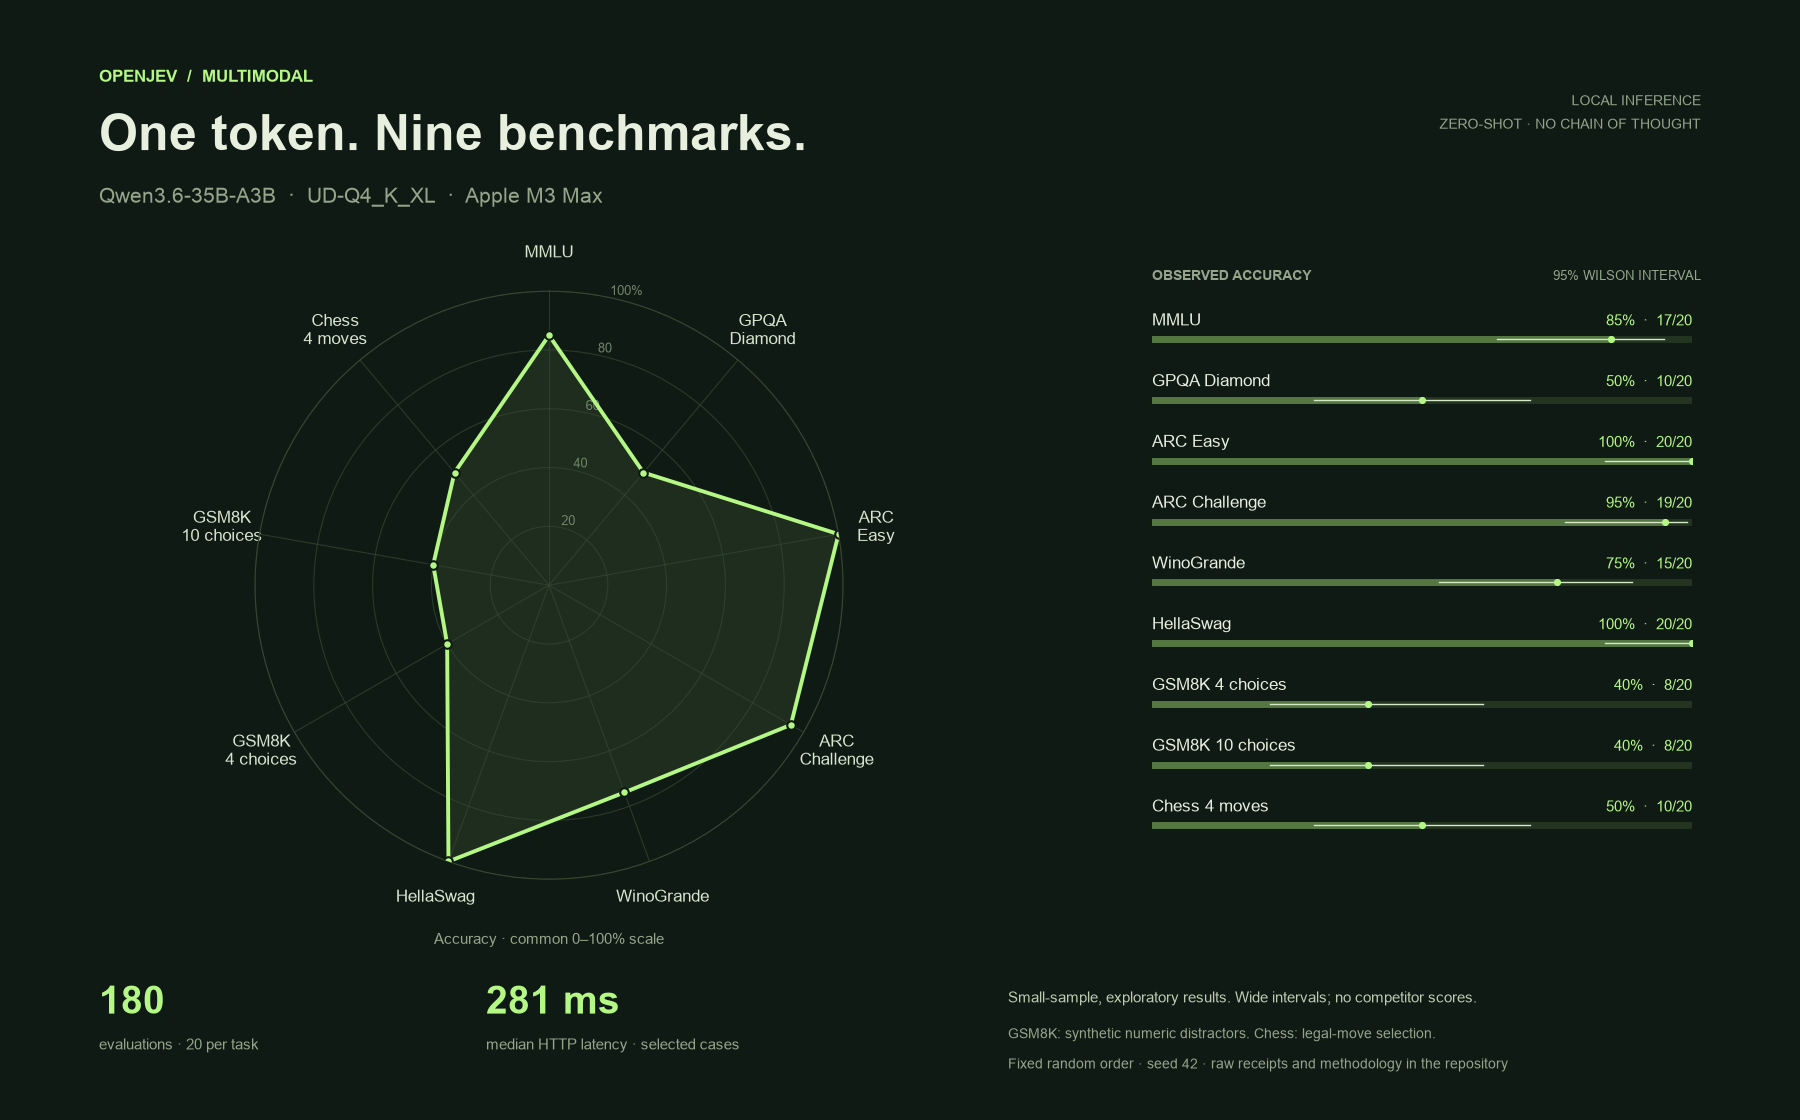
图中只展示我们的 OpenJev Multimodal API。 没有引入 Jev、Terra 或其他项目的分数。
| 任务 | 答对 | 正确率 | 95% Wilson 区间 | HTTP 延迟中位数 |
|---|---|---|---|---|
| MMLU | 17/20 | 85% | 64.0–94.8% | 228 ms |
| GPQA Diamond | 10/20 | 50% | 29.9–70.1% | 294 ms |
| ARC Easy | 20/20 | 100% | 83.9–100.0% | 242 ms |
| ARC Challenge | 19/20 | 95% | 76.4–99.1% | 245 ms |
| WinoGrande | 15/20 | 75% | 53.1–88.8% | 210 ms |
| HellaSwag | 20/20 | 100% | 83.9–100.0% | 362 ms |
| GSM8K · 4 选项 | 8/20 | 40% | 21.9–61.3% | 306 ms |
| GSM8K · 10 选项 | 8/20 | 40% | 21.9–61.3% | 340 ms |
| 国际象棋 · 4 选项 | 10/20 | 50% | 29.9–70.1% | 554 ms |
所选 180 题的 HTTP 延迟中位数为 281 ms。这是探索性小样本,区间较宽;20/20 不等于总体正确率 100%,雷达图面积也不是综合分数。
测试条件
- 模型:Qwen3.6-35B-A3B,UD-Q4_K_XL 权重,配套 F16 视觉投影器。
- 硬件:Apple M3 Max,40 核 GPU,128 GB 统一内存。
- 后端:llama.cpp b9670 /
02810c7aa,Metal,单槽位,8,192 token 上下文。 - 方法:零样本,每题一个输出 token,无生成式推理,选项顺序打乱。
- 选样:原始 seed 42 随机采样顺序中的每项前 20 题,没有按答对与否筛选。
- 延迟:模型已加载时的 HTTP 完整往返,包含准备、推理与缓存影响,不含下载及模型加载;没有隔离桌面其他活动。
最初较大的串行评测已为控制负载而中断,886 条已完成记录全部保留。图表从中取出 180 条现有观察,没有再次发起推理。
任务解释
MMLU 从合并测试集采样,不是各学科宏平均。GPQA Diamond 来自作者公开的加密压缩包,题目和答案文字不公开提交。ARC 使用测试集,WinoGrande 和 HellaSwag 使用有标签的验证集。
GSM8K 被改为多选题:真实数字答案加上可复现的合成数字干扰项,不等于标准自由回答 GSM8K。国际象棋为合成局面合法性任务,从一个合法 UCI 着法和三个非法着法中选择,使用 python-chess 校验;不表示 Elo 或最优着法能力。
这九个维度测试文字判断。图片示例 单独证明视觉链路可用,不构成全面的视觉正确率评测。
低负载复现
bash
# 一次只启动一个模型,推理始终串行
uv run openjev serve --profile quality --threads 4

# 在另一个终端:运行新的小样本,每次请求后休息
uv run --group bench python scripts/benchmark.py \
  --samples 20 --cooldown 0.25 --output benchmarks/local

# 精确复现公开样本 ID 与固定数据版本
uv run --group bench python scripts/benchmark.py \
  --replay-report benchmarks/quality/summary.json \
  --cooldown 0.25 --output benchmarks/replay

# 只重新画图,不发起推理
uv run --group bench python scripts/render_benchmark.py